[미리캔버스] Machine Learning Engineer (Model Inference & Serving)
공고 요약
 직행
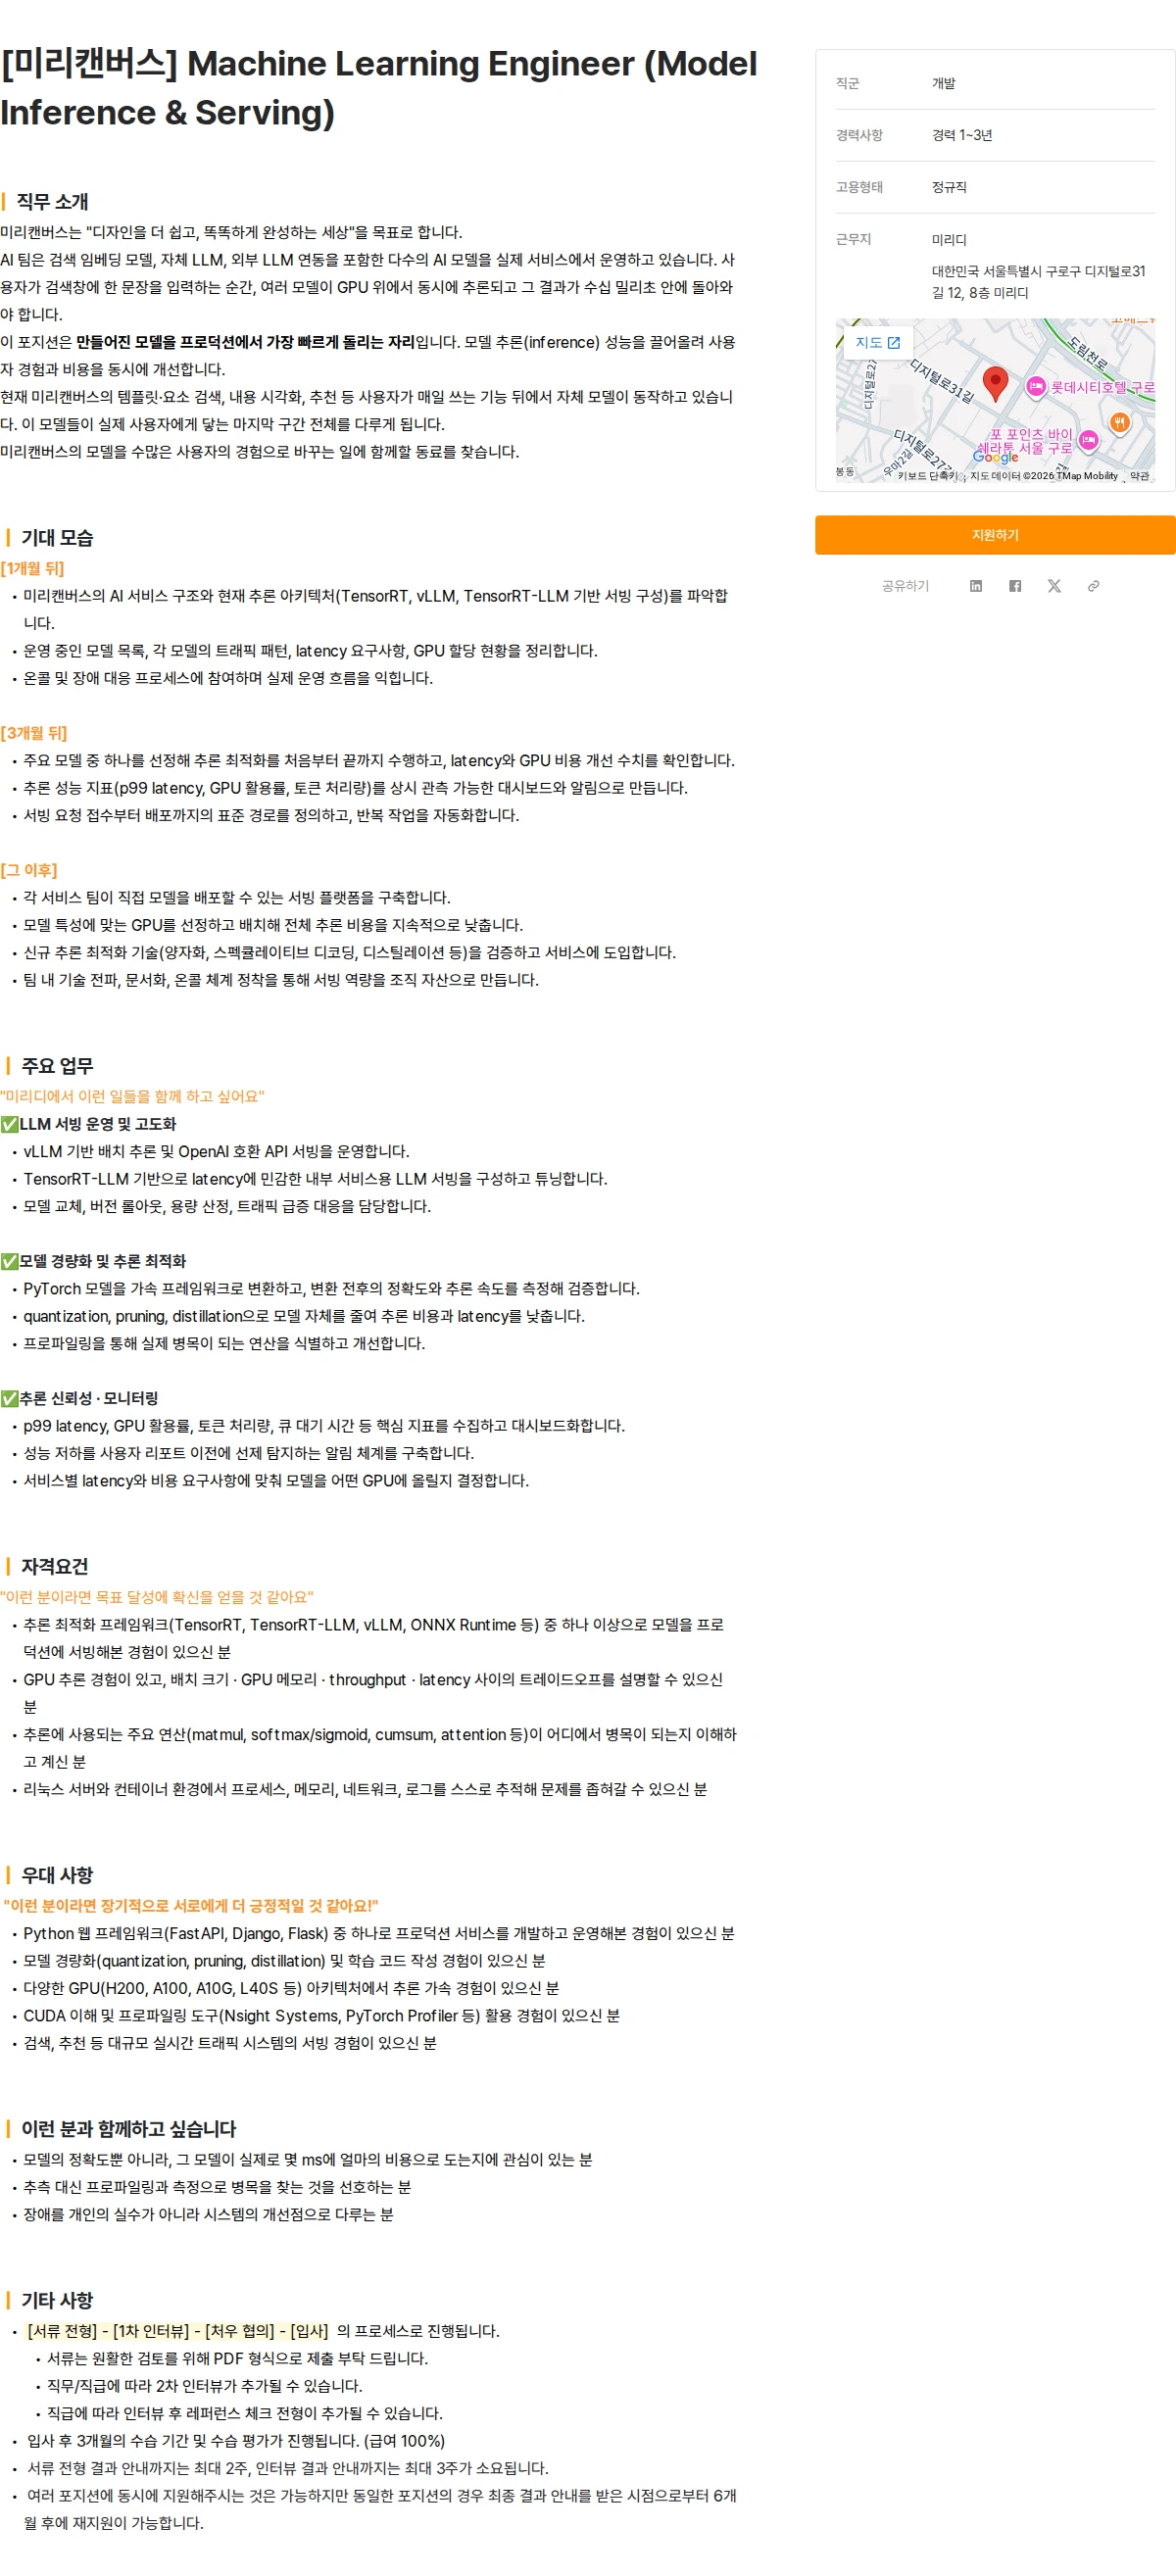
담당업무
vLLM 기반 배치 추론 및 OpenAI 호환 API 서빙 운영
TensorRT-LLM 기반 내부 서비스용 LLM 서빙 구성 및 튜닝
모델 교체, 버전 롤아웃, 용량 산정, 트래픽 급증 대응
PyTorch 모델의 가속 프레임워크 변환 및 변환 전후 정확도·추론 속도 검증
quantization, pruning, distillation을 통한 모델 경량화 및 비용·latency 개선
프로파일링을 통한 병목 연산 식별 및 개선
p99 latency, GPU 활용률, 토큰 처리량, 큐 대기 시간 수집 및 대시보드화
성능 저하 선제 탐지 알림 체계 구축
서비스별 latency·비용 요구사항에 따른 GPU 선정 및 배치
각 서비스 팀이 직접 모델을 배포할 수 있는 서빙 플랫폼 구축
자격요건
TensorRT, TensorRT-LLM, vLLM, ONNX Runtime 등 추론 최적화 프레임워크를 활용한 프로덕션 모델 서빙 경험
GPU 추론 경험 및 배치 크기·GPU 메모리·throughput·latency 트레이드오프 설명 능력
matmul, softmax/sigmoid, cumsum, attention 등 주요 추론 연산의 병목 이해
리눅스 서버와 컨테이너 환경에서 프로세스·메모리·네트워크·로그 추적 능력
우대사항
FastAPI, Django, Flask 등 Python 웹 프레임워크 기반 프로덕션 서비스 개발·운영 경험
quantization, pruning, distillation 등 모델 경량화 및 학습 코드 작성 경험
H200, A100, A10G, L40S 등 다양한 GPU 아키텍처의 추론 가속 경험
CUDA 이해 및 Nsight Systems, PyTorch Profiler 등 프로파일링 도구 활용 경험
검색·추천 등 대규모 실시간 트래픽 시스템 서빙 경험
전형절차
서류 전형
1차 인터뷰
처우 협의
입사
직무·직급에 따라 2차 인터뷰 추가 가능
직급에 따라 인터뷰 후 레퍼런스 체크 추가 가능
접수방법
서류는 PDF 형식으로 제출
여러 포지션 동시 지원 가능
동일 포지션은 최종 결과 안내 후 6개월 뒤 재지원 가능
근무환경
온콜 및 장애 대응 프로세스 참여
p99 latency, GPU 활용률, 토큰 처리량 등 운영 지표 상시 관측
모델 장애를 시스템 개선점으로 다루는 문화
기술 전파와 문서화
온콜 체계 정착 및 서빙 역량의 조직 자산화
마감기한
상시채용
공고 원문
이런 공고는 어때요?
JPMorganChase
2년 이상 · 정규직 · 해외
직행JPMorganChase
2년 이상 · 정규직 · 해외
직행JPMorganChase
3년 이상 · 정규직 · 해외
직행JPMorganChase
3년 이상 · 정규직 · 해외
직행
SAP
3년 이상 · 정규직 · 서울
직행
미래에셋증권
2년 이상 · 정규직 · 서울
직행
마이크로소프트(Microsoft)
1년 이상 · 정규직 · 해외
직행마이크로소프트(Microsoft)
3년 이상 · 정규직 · 해외
직행
님버스테크
20년 이하 · 계약직 · 서울
 그룹바이
JPMorganChase
3년 이상 · 정규직 · 해외
직행
퀀텀에이아이
2년~10년 · 정규직 · 서울
 로켓펀치
마이크로소프트(Microsoft)
1년 이상 · 정규직 · 해외
직행
Salesforce
2년~4년 · 정규직 · 해외
직행
트레독스
3년~10년 · 정규직 · 서울
그룹바이
마키나락스
2년~8년 · 정규직 · 서울
 원티드
카카오
2년 이상 · 정규직 · 경기
 잡코리아
골드만삭스
1년 이상 · 정규직 · 해외
직행
어쎈드
2년~7년 · 정규직 · 서울
원티드
바이언스
1년~8년 · 정규직 · 서울
 랠릿
플루이즈
1년~35년 · 정규직 · 서울
원티드